Treinar de novo um modelo de IA gigante exige laboratórios e supercomputadores caríssimos. O LoRA muda esse cenário: em vez de recalcular bilhões de conexões, ele mantém o modelo original intacto e treina apenas um adaptador minúsculo. O vídeo curto abaixo, de pouco mais de um minuto e produzido com o NotebookLM, mostra a ideia na prática.
O problema de atualizar um modelo inteiro
Imagine pegar uma inteligência artificial genérica e tentar ensiná-la a raciocinar como um médico especialista. O método padrão tenta recalcular bilhões de conexões de uma vez, e isso trava qualquer placa de vídeo comum: a memória (VRAM) enche e o treino termina no erro CUDA out of memory.
Como o LoRA resolve
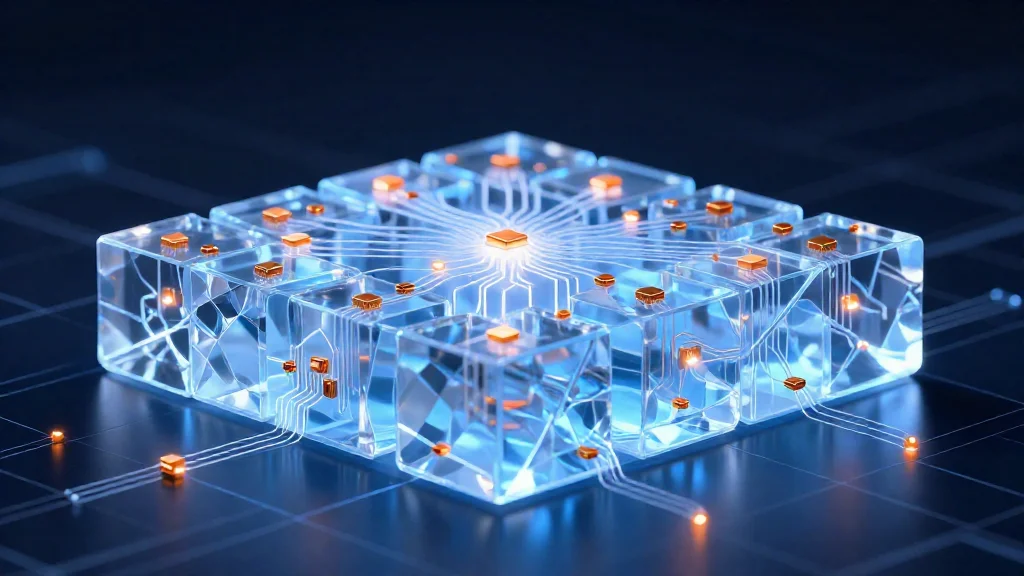
- Congela o conhecimento original: os pesos do modelo base ficam travados e nenhum gradiente é calculado neles.
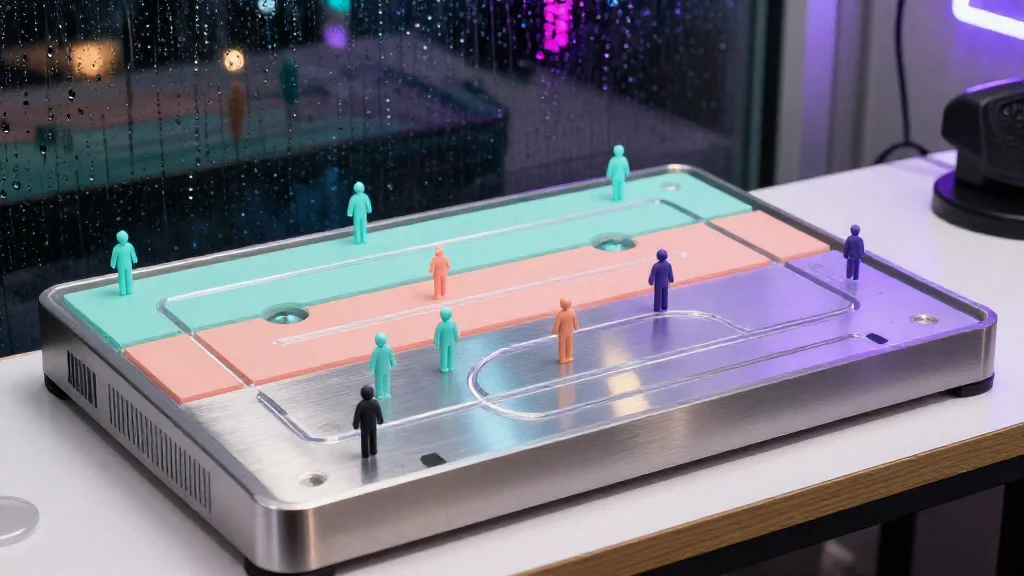
- Cria um caminho paralelo minúsculo: o adaptador é formado por duas matrizes pequenas, A e B, de baixo posto (rank muito menor que a dimensão original).
- Treina só o adaptador: são menos de 1% dos parâmetros, uma fração mínima do processamento.
- Soma as duas saídas na hora de responder: o resultado é a resposta da base congelada mais a contribuição do adaptador, que carrega a nova especialidade.
Por que isso importa
Como só o adaptador é treinado, desenvolvedores conseguem criar modelos superespecialistas usando a placa de vídeo do próprio computador, sem depender de um data center. O adaptador resultante é pequeno, fácil de guardar e de trocar, e o modelo original continua o mesmo.
Quer fazer isso na prática?
No nosso guia completo de fine-tuning com LoRA e QLoRA você vê o passo a passo com código, as versões atuais das bibliotecas e como evitar o erro de memória que o vídeo menciona.