NVIDIA anuncia nova configuração de 64GB do DGX Spark para execução de agentes de IA locais
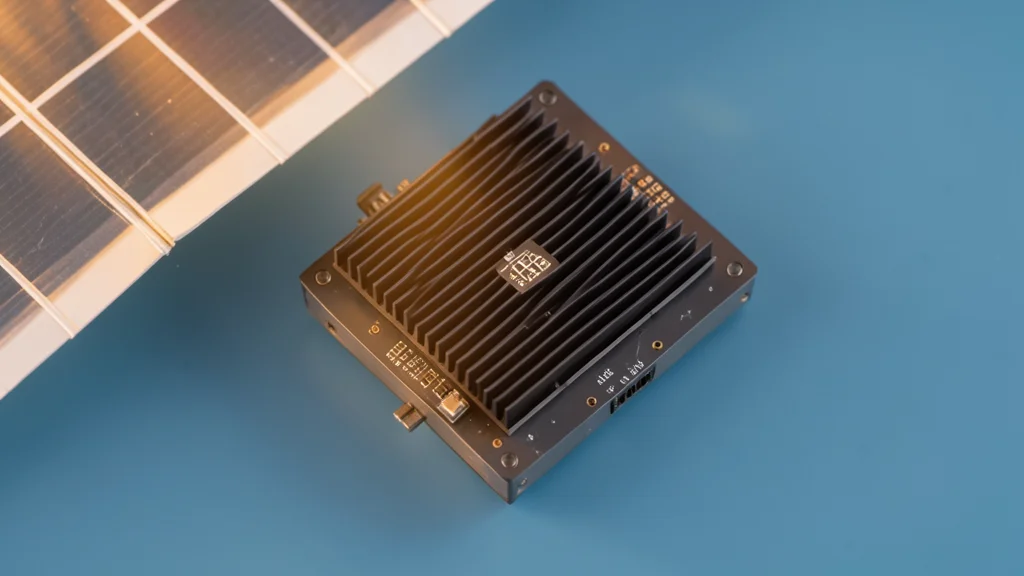
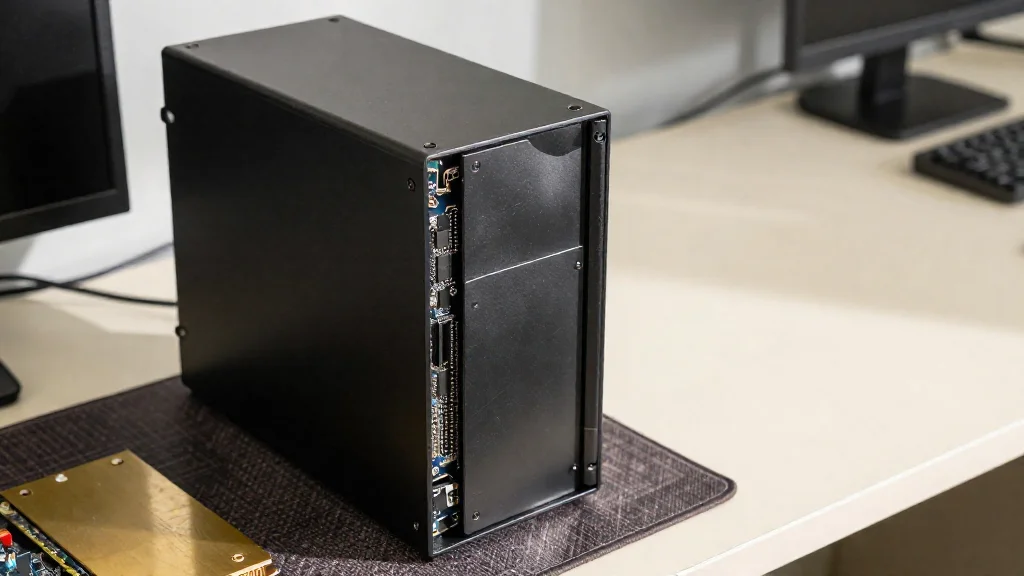
A NVIDIA apresentou uma nova versão do DGX Spark equipada com 64GB de memória unificada, ampliando o portfólio do que a empresa chama de supercomputador pessoal de inteligência artificial. O equipamento, baseado no superchip GB10 Grace Blackwell, será comercializado a partir de 23 de outubro de 2026 por meio de parceiros OEMs como Acer, ASUS, Dell, Gigabyte, HP e MSI, além do NVIDIA Marketplace e do varejo. O lançamento acontece em um cenário de crescimento acelerado do consumo de tokens por agentes de IA, que têm multiplicado por 14 desde o início de 2026, segundo dados apresentados pela própria NVIDIA.
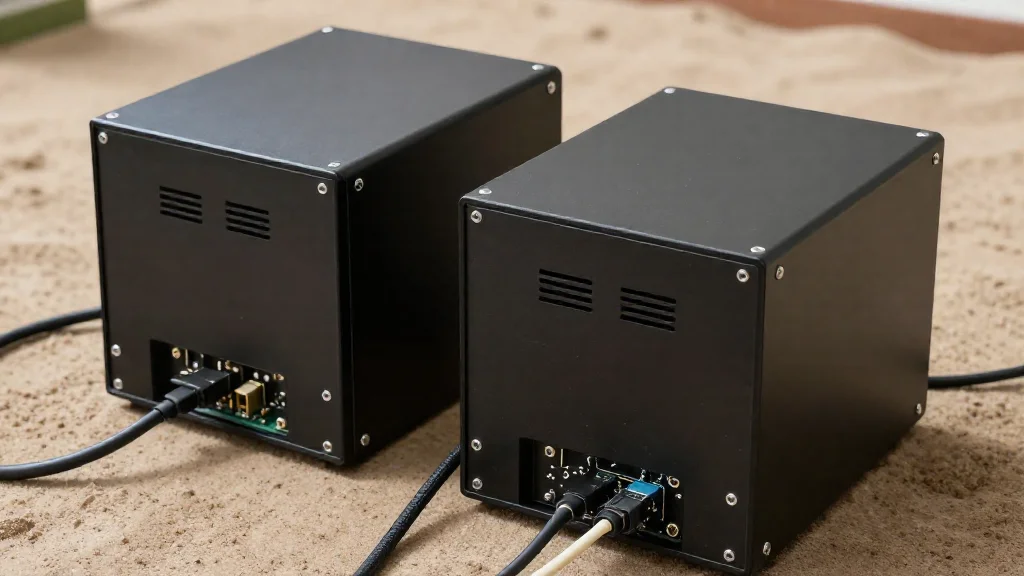
A proposta central da nova configuração é oferecer aos desenvolvedores uma alternativa ao uso de APIs de nuvem com cobrança por token. Com o DGX Spark 64GB, é possível executar modelos abertos e agentes sempre ativos diretamente na máquina local, sem custo adicional por inferência. Para aplicações mais pesadas, duas unidades de 64GB podem ser conectadas em cluster, somando 128GB de memória e o dobro de capacidade de computação, por meio da tecnologia ConnectX-7.
No coração do hardware está o superchip GB10, que combina uma GPU baseada na arquitetura Blackwell com núcleos Tensor de quinta geração e uma CPU Grace Arm de 20 núcleos, divididos em dez Cortex-X925 e dez Cortex-A725. A GPU entrega até um petaFLOP de desempenho em IA no formato FP4 com esparsidade, métrica que se refere a uma técnica de otimização que descarta valores zero em cálculos para acelerar o processamento. A memória unificada de 64GB é do tipo LPDDR5x, com largura de banda de 273 GB/s, e pode ser complementada por até 4TB de armazenamento NVMe M.2 com criptografia automática.
Um dos destaques técnicos da arquitetura é o uso da interconexão NVLink-C2C, que oferece cinco vezes mais largura de banda do que o PCIe Gen 5. Esse recurso permite que CPU e GPU compartilhem um único pool de memória, eliminando a necessidade de copiar pesos entre a RAM do sistema e a memória de vídeo dedicada. Na prática, isso viabiliza que múltiplos modelos, seus caches de chave-valor (estruturas que armazenam informações temporárias durante o processamento de linguagem) e processos de ferramentas convivam em um único espaço de endereçamento, o que é especialmente útil para agentes de IA.
O sistema sai da caixa com o DGX OS, versão baseada no Ubuntu da NVIDIA que já vem com PyTorch, Jupyter e Ollama pré-instalados. O pacote de software também inclui o NemoClaw, que adiciona controles de privacidade e segurança a agentes baseados em OpenClaw, e o OpenShell, componente do NVIDIA Agent Toolkit responsável por aplicar barreiras de proteção baseadas em políticas. Modelos da família Nemotron vêm otimizados de fábrica para o hardware. O equipamento funciona em tomada comum, sem necessidade de sala de servidores ou refrigeração especial, característica relevante para um dispositivo pensado para operar de forma contínua.
Segundo a NVIDIA, os 64GB são suficientes para rodar os modelos abertos mais capazes da atualidade na faixa de 30 a 35 bilhões de parâmetros. Entre os modelos destacados estão o Muse Glimmer, da Meta, um modelo denso de 29,6 bilhões de parâmetros com pesos próximos de 17GB após quantização, técnica que reduz a precisão dos números para economizar memória; o Nemotron 3.5 Lightning, da própria NVIDIA, um modelo de arquitetura Mixture of Experts (MoE) com 30 bilhões de parâmetros totais, dos quais apenas 3 bilhões são ativados por inferência, no formato NVFP4; e o Qwen3.8-27B, da Alibaba Qwen, com aproximadamente 4.74GB de pesos em versão de 4 bits, voltado para tarefas gerais de agente e codificação.
A nova configuração abre espaço para casos de uso como agentes pessoais sempre ativos, que podem ser integrados a repositórios do GitHub, executores de testes e feeds de artigos acadêmicos; ajuste fino de modelos de codificação sobre o próprio código da empresa, com técnicas como QLoRA, método que permite treinar modelos grandes gastando menos memória; bancadas de avaliação de modelos no dia do lançamento; times multiagente que compartilham o mesmo pool de memória; e prototipagem de aplicações de borda e robótica, com posterior implantação em dispositivos Jetson.
Para cargas de trabalho que excedem a capacidade de uma única unidade, a NVIDIA destaca o agrupamento por meio do NVIDIA Sync, software de gerenciamento compatível com Windows e macOS que descobre sistemas na rede e configura a comunicação entre eles. O Cluster Assistant pode interligar até quatro DGX Spark via ConnectX-7, com velocidades de 200GbE, formando anéis ou estrelas sem necessidade de switch em configurações menores. Dois sistemas de 64GB agrupados entregam até 1,7 vez o desempenho de um DGX Spark de 128GB, segundo a empresa, e quatro unidades podem chegar a 512GB de memória agrupada.
A versão de 128GB do DGX Spark continua sendo oferecida para cargas maiores em uma única caixa. As principais aplicações do modelo de 64GB, segundo a NVIDIA, são agentes sempre ativos, ajuste fino via QLoRA e avaliações no dia do lançamento, justamente os cenários em que a cobrança por token em APIs de nuvem se torna economicamente desvantajosa para o desenvolvedor.